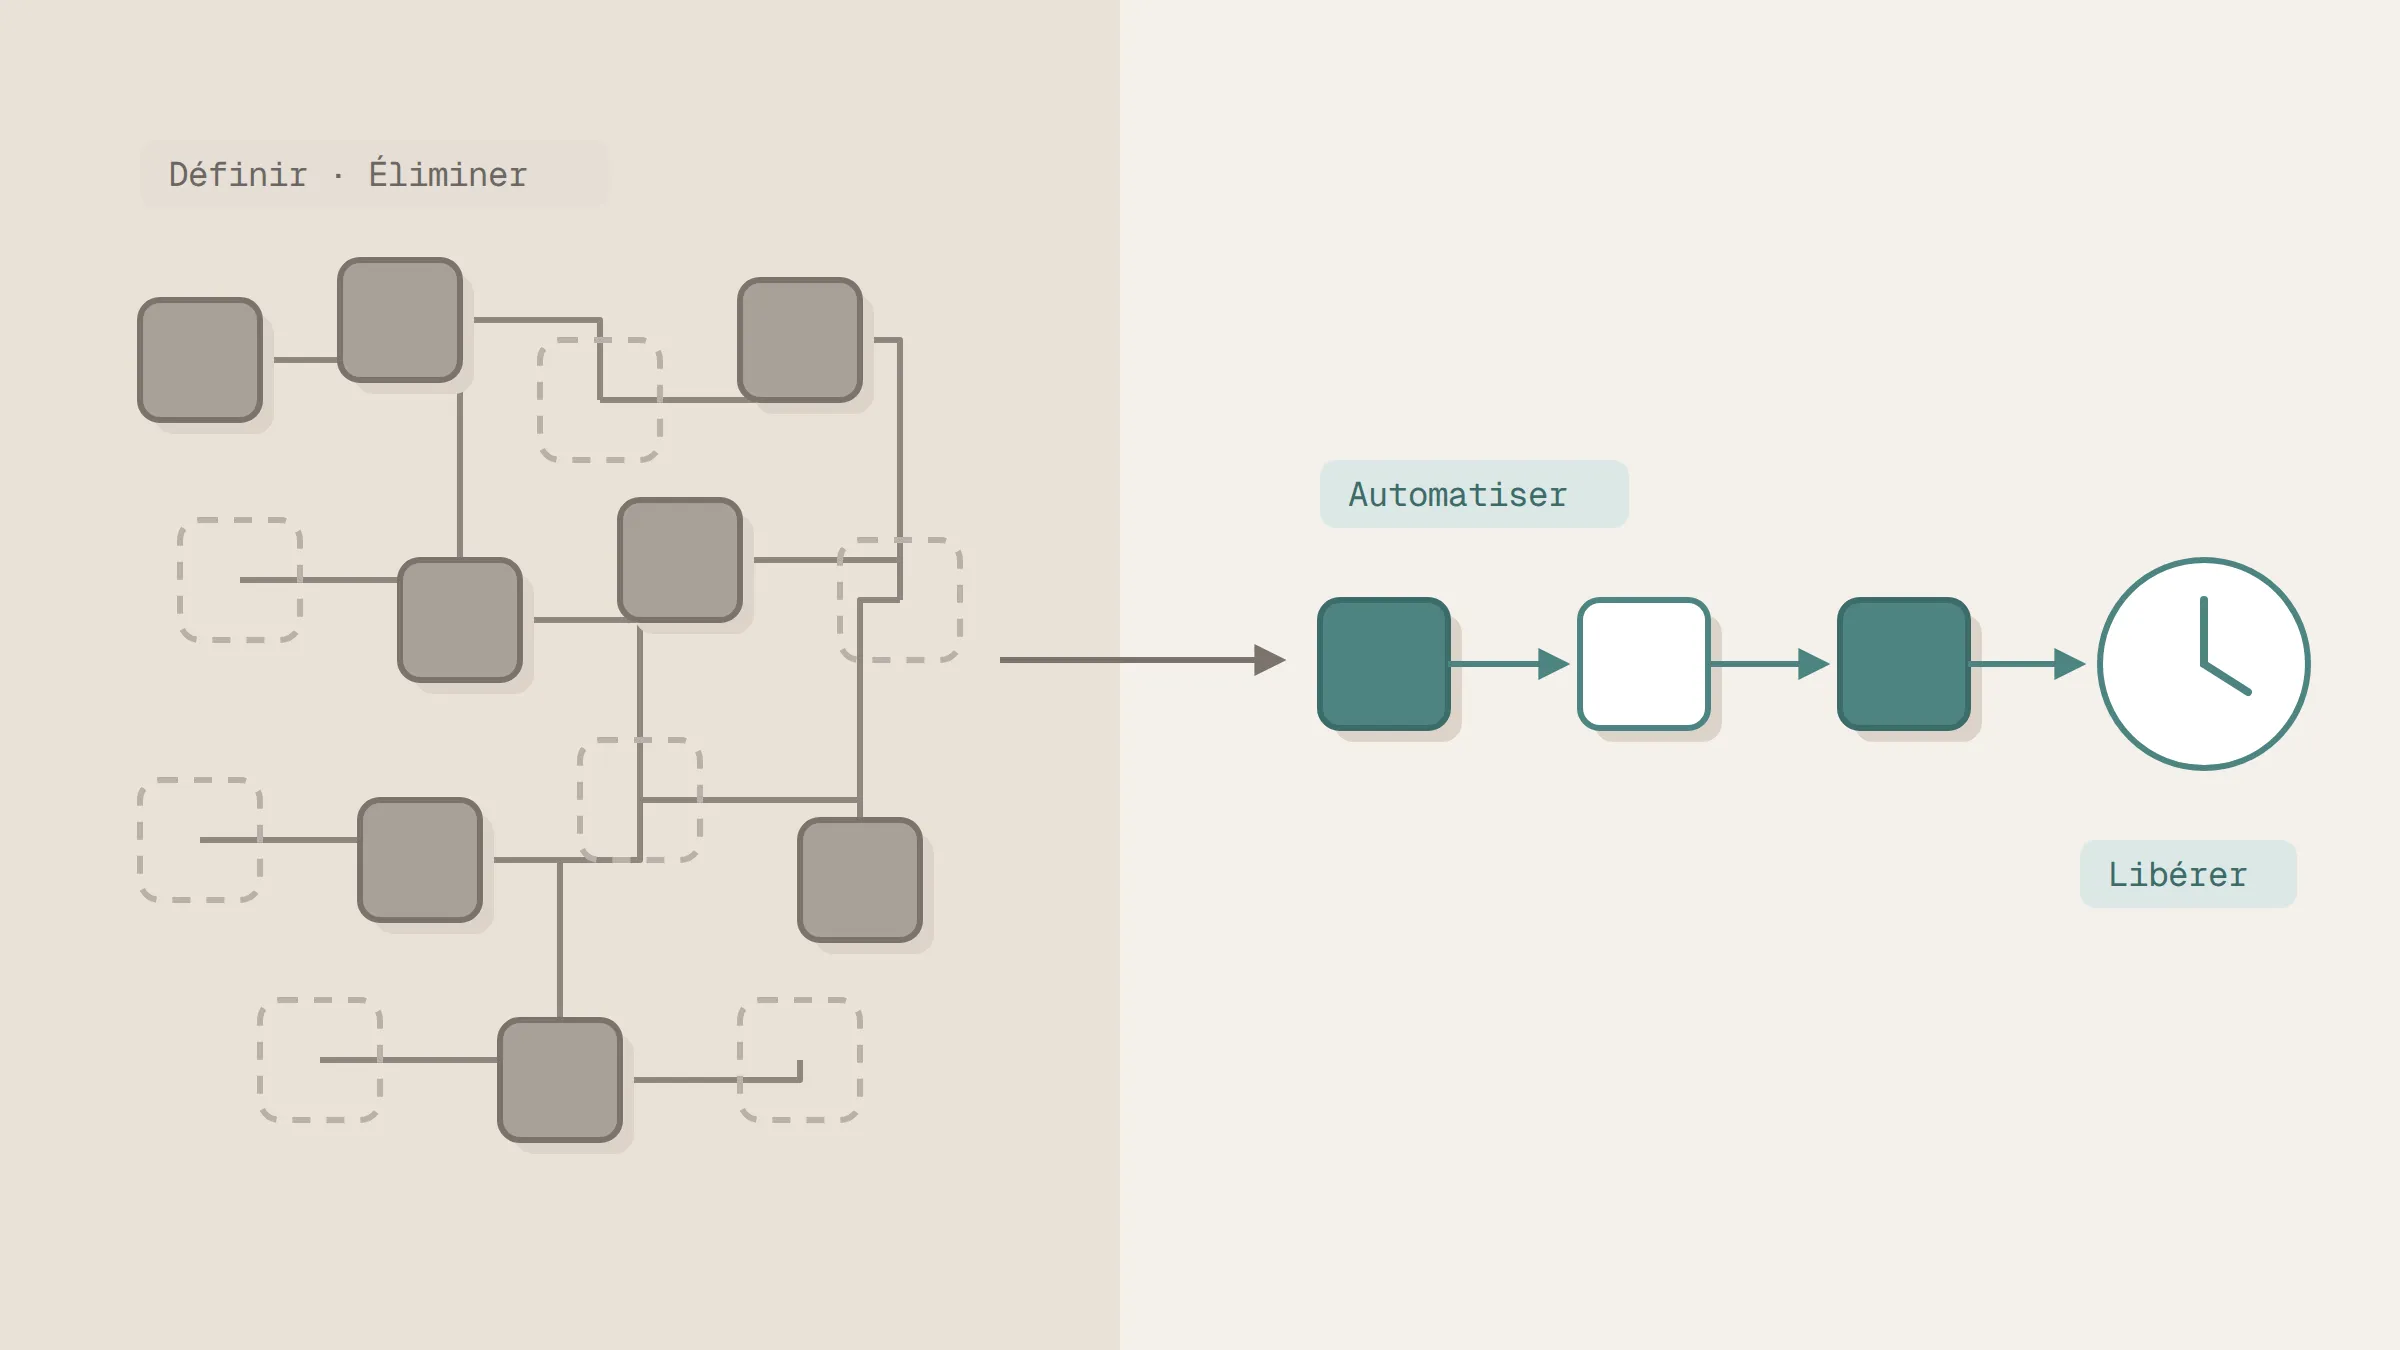
La méthode DEAL, tirée de La Semaine de 4 heures de Tim Ferriss, enchaîne quatre étapes : définir, éliminer, automatiser, libérer. Appliquée aux process d’une PME, elle impose un ordre que beaucoup de projets d’automatisation inversent en commençant par l’outil. On élimine avant d’automatiser, parce qu’une étape inutile, une fois automatisée, tourne sans que personne ne la remette en cause. Et on automatise avec des règles fixes avant de penser IA, parce que la plupart des tâches répétitives d’une entreprise suivent des règles qu’on sait écrire.
Qu’est-ce que la méthode DEAL de Tim Ferriss ?
La méthode DEAL est la démarche en quatre étapes (Définition, Élimination, Automatisation, Libération) qui structure The 4-Hour Workweek, le livre de Tim Ferriss paru aux États-Unis en 2007 et traduit en français chez Pearson en 2008 sous le titre La Semaine de 4 heures. Le livre s’adresse à des personnes qui veulent reprendre la main sur leur temps de travail.
Chez Ferriss, définir revient à fixer précisément où l’on veut aller, et éliminer à retirer ce qui ne sert pas, à l’aide d’une analyse 80/20. Automatiser consiste à poser « les règles et les politiques » qui gouvernent sa vie et son entreprise. Libérer, enfin, c’est profiter du temps et de l’espace ainsi dégagés.
En octobre 2026, Ferriss y est revenu dans un épisode de questions-réponses de son podcast, où il relit sa méthode à la lumière de l’IA. Il y estime que les deux premières étapes, définir et éliminer, comptent de plus en plus, parce que les outils d’IA sont des accélérateurs : ils « font davantage de ce qui existe déjà ». Utilisée sans discernement, l’IA « multiplie l’inutile », et l’on finit par automatiser des tâches qui n’auraient jamais dû exister.
La méthode DEAL appliquée aux process d’une PME
Dans une PME, la méthode s’applique à un process, c’est-à-dire à une suite d’étapes qui transforme une demande en résultat : une commande en facture, une réclamation en remboursement.
| Étape | Chez Ferriss (2007) | Dans une PME | Ce qui en sort |
|---|---|---|---|
| Définition | Fixer où l’on veut aller | Écrire le résultat attendu, cartographier le process tel qu’il tourne | Une carte avec volumes, fréquences et irritants |
| Élimination | Retirer le superflu, analyse 80/20 | Supprimer étapes, doubles saisies et validations sans valeur | Un process plus court, sans outil ajouté |
| Automatisation | Poser des règles, déléguer | Confier ce qui reste à des scénarios à règles (outils d’automatisation comme n8n ou Make, ou code), l’IA seulement où les règles ne suffisent pas | Des scénarios supervisés, avec alerte en cas d’échec |
| Libération | Profiter du temps dégagé | Réaffecter les heures rendues et mesurer l’écart | Un avant et un après chiffrés |
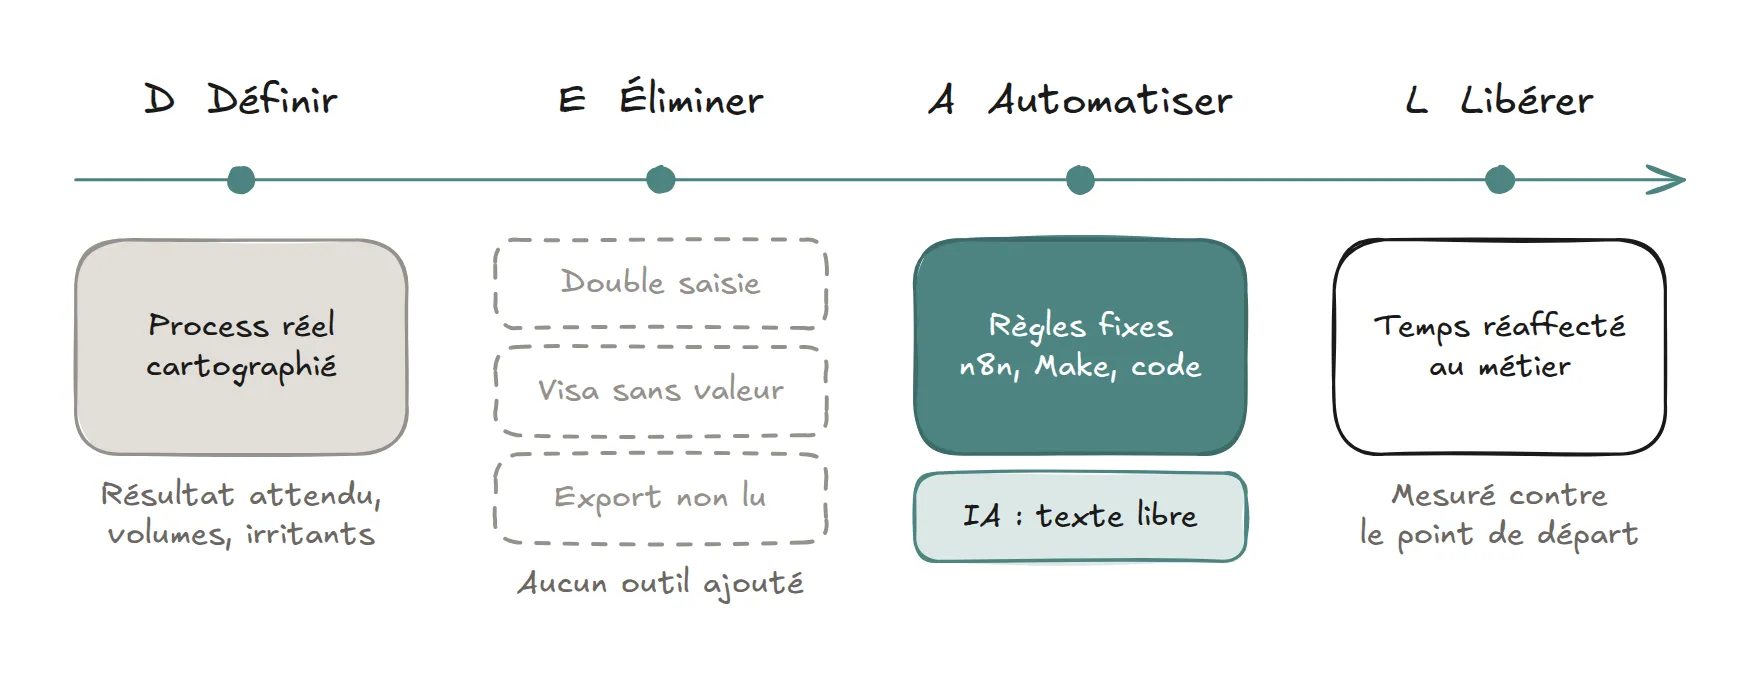 L’étape E retire des étapes sans ajouter d’outil. À l’étape A, les règles portent presque tout, et l’IA n’intervient que sur le texte libre.
Définir : quel résultat attendre du process, et à quel volume ?
Définir un process consiste à écrire en une phrase le résultat attendu, puis à dessiner le process tel qu’il tourne réellement, avec ses volumes, ses fréquences et ses irritants. Le résultat se formule comme une sortie vérifiable : « les factures partenaires du mois envoyées avant le 5, sans correction » plutôt que « automatiser la facturation ». La seconde formule désigne un moyen ; la première dit à quoi l’on reconnaîtra que le projet a réussi.
La cartographie se fait avec les personnes qui exécutent le process. Elle répond à cinq questions :
- Qu’est-ce qui déclenche le process : une commande payée, la fin du mois, un email entrant ?
- Quelles sont les étapes, qui les fait, et dans quel outil ?
- Combien d’éléments passent, et combien de fois par mois ?
- Où sont les irritants : ressaisies, attentes, erreurs qui reviennent, fichiers recopiés ?
- Combien d’heures le process consomme-t-il chaque mois ? Ce chiffre servira de point de départ à la dernière étape.
Chez Goodloop, qui répare des textiles techniques dans son atelier de Lyon, l’outil d’opérations construit dans Airtable a d’abord été conçu en séance de travail avec l’équipe. Les commandes y arrivent par trois canaux (le site pour les particuliers, les marques partenaires, des points de collecte chez des revendeurs), et chacun a ses propres règles de paiement, d’expédition et de facturation. Seule l’équipe pouvait décrire ces règles avec précision. Cette étape de définition forme le premier temps d’un audit des process et des usages de l’IA.
Quand la description du process révèle un autre problème
Un client m’a un jour décrit son besoin ainsi : son outil de facturation des partenaires n’était pas relié au suivi des commandes. Chaque mois, une personne reprenait 400 commandes une à une pour savoir à quel partenaire facturer chacune, et éditait ainsi 20 factures. Son réflexe était de confier cette vérification à une IA. Une fois le process dessiné, le vrai problème apparaissait : deux outils ne se parlaient pas, et une personne recopiait à la main les informations de l’un vers l’autre.
Une IA qui devine, ligne après ligne, à quel partenaire rattacher une commande aurait produit des factures fausses sans dire lesquelles. Il fallait donc d’abord vérifier ce que ces deux outils savaient déjà échanger, soit par une connexion prévue par leurs éditeurs, soit par leur API, c’est-à-dire l’accès qui permet à un autre logiciel de lire et d’écrire leurs données.
Pourquoi éliminer avant d’automatiser ?
Éliminer avant d’automatiser évite de rendre permanente une étape qui ne sert à rien : une fois automatisée, elle s’exécute sans que personne ne la voie, et plus personne ne pense à la supprimer. L’idée n’a rien de neuf. En 1990, Michael Hammer titrait un article de la Harvard Business Review « Reengineering Work: Don’t Automate, Obliterate » : n’automatisez pas, supprimez.
Ce qui part à cette étape se repère sur la carte du process :
- les doubles saisies, quand la même information est tapée dans deux outils faute d’un outil de référence ;
- les validations sans valeur, comme un visa qui n’a jamais rien refusé ;
- les exports et les tableaux de suivi que personne ne lit ;
- les branches prévues pour des cas qui n’arrivent plus.
L’élimination ne demande souvent aucun outil. Dans l’exemple de la facturation des partenaires, noter le partenaire au moment de la commande supprime la vérification ligne à ligne de fin de mois. Retirer une seconde signature de validation ne demande qu’une décision.
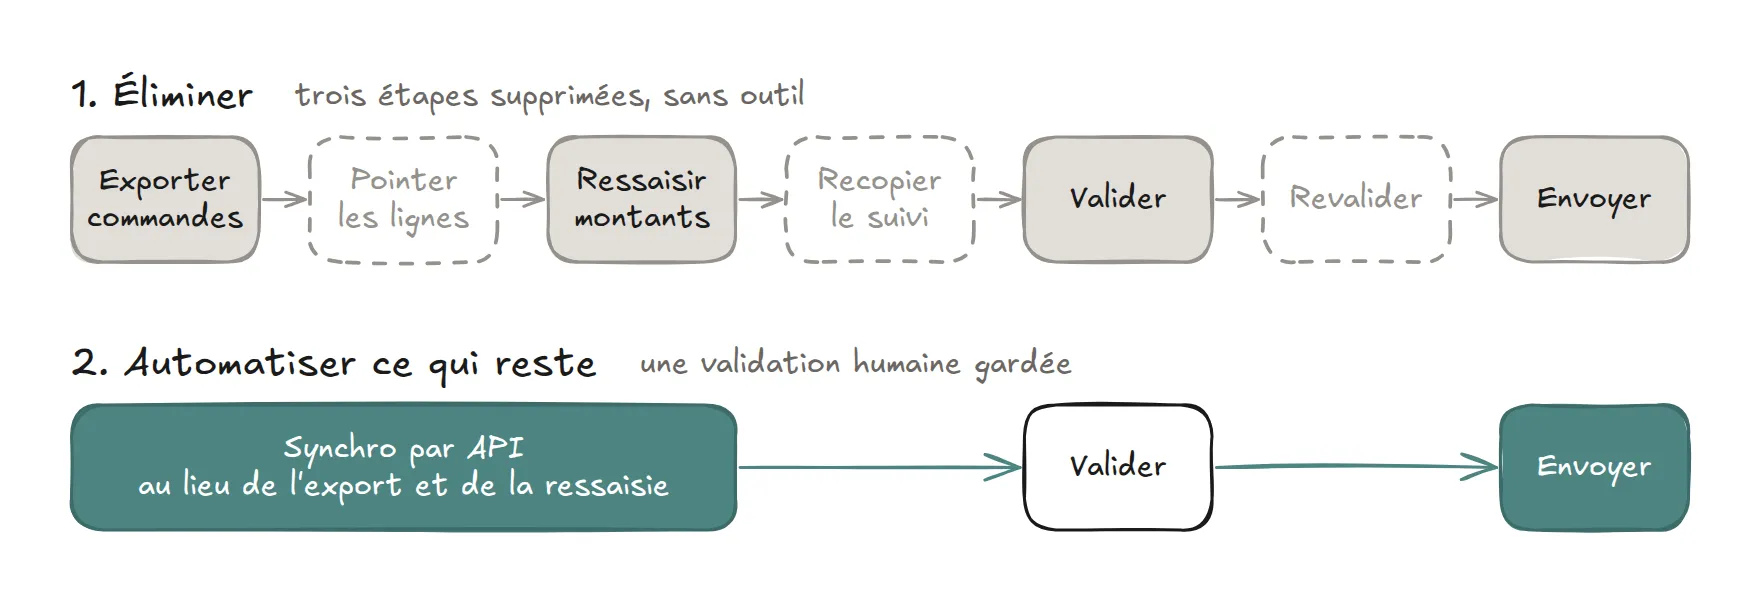 Trois étapes disparaissent sans aucun outil. L’automatisation ne porte ensuite que sur ce qui reste, et la validation humaine est gardée.
Une automatisation d’emails ramenée de 120 étapes à 19
L’exemple que je connais le mieux est une automatisation que j’avais construite moi-même. Chez Goodloop, les emails de suivi de commande partaient de Make, un outil qui enchaîne des actions entre logiciels selon des règles. En deux ans, l’automatisation avait grossi jusqu’à 120 étapes, avec une copie complète par langue et chaque email programmé séparément. Je la montrais à mes élèves du Wagon, une école de programmation, comme exemple de ce qu’il ne faut pas faire (mea culpa : j’aurais dû la découper en automatisations plus petites bien plus tôt).
Lors de la migration de Make vers n8n, un outil du même type, j’ai reconstruit la logique au lieu de la recopier. Les règles qui choisissaient l’email à envoyer, jusque-là dispersées dans toute l’automatisation, tiennent désormais dans un seul tableau. L’automatisation principale est passée de 120 étapes à 19, avec un seul envoi d’email au lieu de 23 copies.
Le changement d’outil a aidé : jusqu’en mars 2026, Make ne permettait pas de réunir deux branches d’une automatisation après un embranchement, ce qui obligeait à dupliquer la suite. Le gain vient pourtant de la suppression des copies et des doublons : recopiée étape par étape dans n8n, l’automatisation aurait gardé ses 120 étapes.
Automatiser : pourquoi des règles fixes avant l’IA ?
Les règles fixes passent avant l’IA parce qu’une automatisation déterministe produit toujours la même sortie pour la même entrée, coûte peu à chaque exécution et laisse une trace qu’on relit étape par étape. C’est ce que fait un scénario n8n ou Make, ou quelques dizaines de lignes de code, en appliquant des règles écrites. Cela couvre la plupart des tâches répétitives d’une PME : recopier une commande d’un outil à l’autre, générer une étiquette d’expédition, envoyer le bon email au bon statut, préparer la facturation du mois.
Les tâches qu’une règle fixe suffit à traiter
En mai 2025, j’écrivais un cours sur n8n et l’IA pour Le Wagon, et j’y défendais une thèse : 95 % des automatisations n’ont pas besoin d’IA. Le chiffre est une estimation de praticien, sans étude derrière ; il indique surtout dans quel ordre regarder les choses. Avant de penser IA, il faut connaître les outils en place, regarder les connexions prévues par leurs éditeurs et les API qu’ils proposent, et construire des scénarios déterministes.
J’en ai fait l’expérience à l’été 2026, en passant d’un abonnement IA illimité à une facturation à l’usage, où chaque demande se paie. Demander à l’un des modèles d’IA les plus puissants de centrer les cellules d’un Google Sheet revenait déjà à environ 2 dollars. Je confiais aussi à l’IA une tâche qui suit toujours la même règle : après chaque appel, récupérer la transcription de la réunion et cocher des cases dans mon CRM, le logiciel de suivi de mes clients. Je l’ai reconstruite dans n8n, sans IA : elle donne le même résultat à chaque exécution et ne coûte plus rien en usage d’IA. Une tâche qui suit une règle fixe n’a pas besoin d’IA, et la confier à un modèle la fait payer à chaque exécution.
Chez Goodloop, les tâches qui tournent sans intervention sont des scénarios à règles : suivi client, étiquettes d’expédition, facturation des partenaires, déclaration du bonus réparation et remboursements. L’équipe est alertée dès qu’un traitement échoue, si bien qu’aucune commande ne reste bloquée sans qu’elle le sache. C’est le principe des automatisations entre logiciels que je construis : des règles lisibles, et une alerte quand elles échouent.
Les tâches où l’IA devient utile
L’IA se justifie là où une règle ne suffit pas : lire un email rédigé librement, extraire les champs d’un PDF dont le format change, classer une demande, proposer un brouillon de réponse. Dans ces cas, elle s’insère à un endroit précis d’un scénario déterministe, et un humain valide ce qu’elle produit.
L’IA sert aussi à construire les automatisations. Pour la migration Goodloop, Claude Code, un assistant d’IA qui écrit du code, a retrouvé environ 80 % des règles en lisant le fichier exporté depuis Make. Les 20 % restants demandaient de connaître le métier de Goodloop : l’IA accélère la reprise d’une automatisation, sans remplacer cette connaissance.
| Critère | Scénario à règles (n8n, Make, code) | Étape confiée à l’IA |
|---|---|---|
| Entrée | Champs, statuts, montants | Texte libre, documents, demandes de clients |
| Résultat | Identique à chaque exécution | Variable, à faire valider |
| Erreur | Reproductible, corrigée une fois pour toutes | Plausible, parfois invisible sans relecture |
| Coût d’exécution | Faible et prévisible | Proportionnel au volume de texte traité par le modèle |
| Exemples | Étiquettes, facturation mensuelle, emails de suivi | Tri des emails, lecture de PDF, brouillon de réponse |
Libérer : que faire du temps gagné, et comment le mesurer ?
Libérer consiste à décider à l’avance ce que deviendront les heures rendues par l’automatisation, puis à vérifier qu’elles ont bien été rendues. Sans décision, le temps gagné se dissout dans les urgences du mois suivant, et le projet donne l’impression de n’avoir rien changé.
Chez Goodloop, l’équipe ne saisit plus les commandes et ne prépare plus les étiquettes à la main : elle se consacre à la réparation, qui est son métier. Le projet a aussi servi au-delà des heures gagnées. La base de données construite pour les opérations a servi de fondation à Goodloop Pro, l’espace en ligne où les marques partenaires passent commande et suivent leurs réparations, mis en service en six semaines.
La mesure se prépare dès l’étape de définition. Dans le cas de la facturation des partenaires, le point de départ tient en une ligne : 400 commandes vérifiées une à une chaque mois pour 20 factures. Après la mise en production, trois indicateurs suffisent : les heures passées par mois, le délai entre la fin du mois et l’envoi des factures, et le nombre de corrections demandées par les partenaires.
Par où commencer l’automatisation des process d’une PME ?
Le bon point de départ est un process récurrent, à volume régulier, que l’équipe trouve pénible et dont le résultat tient en une phrase. La démarche se déroule dans cet ordre :
- Lister les process qui reviennent chaque semaine ou chaque mois, avec pour chacun le volume et le temps passé.
- Retenir celui où le volume et l’irritation se cumulent ; la facturation mensuelle, le suivi des commandes et la ressaisie entre deux outils arrivent souvent en tête.
- Le cartographier en une demi-journée avec les personnes qui l’exécutent.
- Barrer les étapes sans valeur avant de parler d’outil.
- Vérifier ce que les outils en place savent déjà faire : connexions prévues par leurs éditeurs, API, exports programmés.
- Automatiser d’abord le cas le plus simple, pour vérifier que l’outil est bien installé et relié aux logiciels de l’entreprise, puis passer aux cas plus complexes. Pour la migration Goodloop, j’ai commencé par l’alerte en cas d’erreur, puis les échanges de données entre logiciels, et j’ai terminé par l’envoi des emails de suivi de commande.
- Mesurer après un mois contre le point de départ, puis choisir le process suivant.
Si l’IA a sa place, elle intervient aux étapes 5 et 6 de cette démarche, et seulement sur la partie du process que des règles fixes ne couvrent pas. Un audit des process suit ce déroulé : la cartographie, la liste des étapes à supprimer, puis un plan d’automatisation chiffré en heures gagnées.