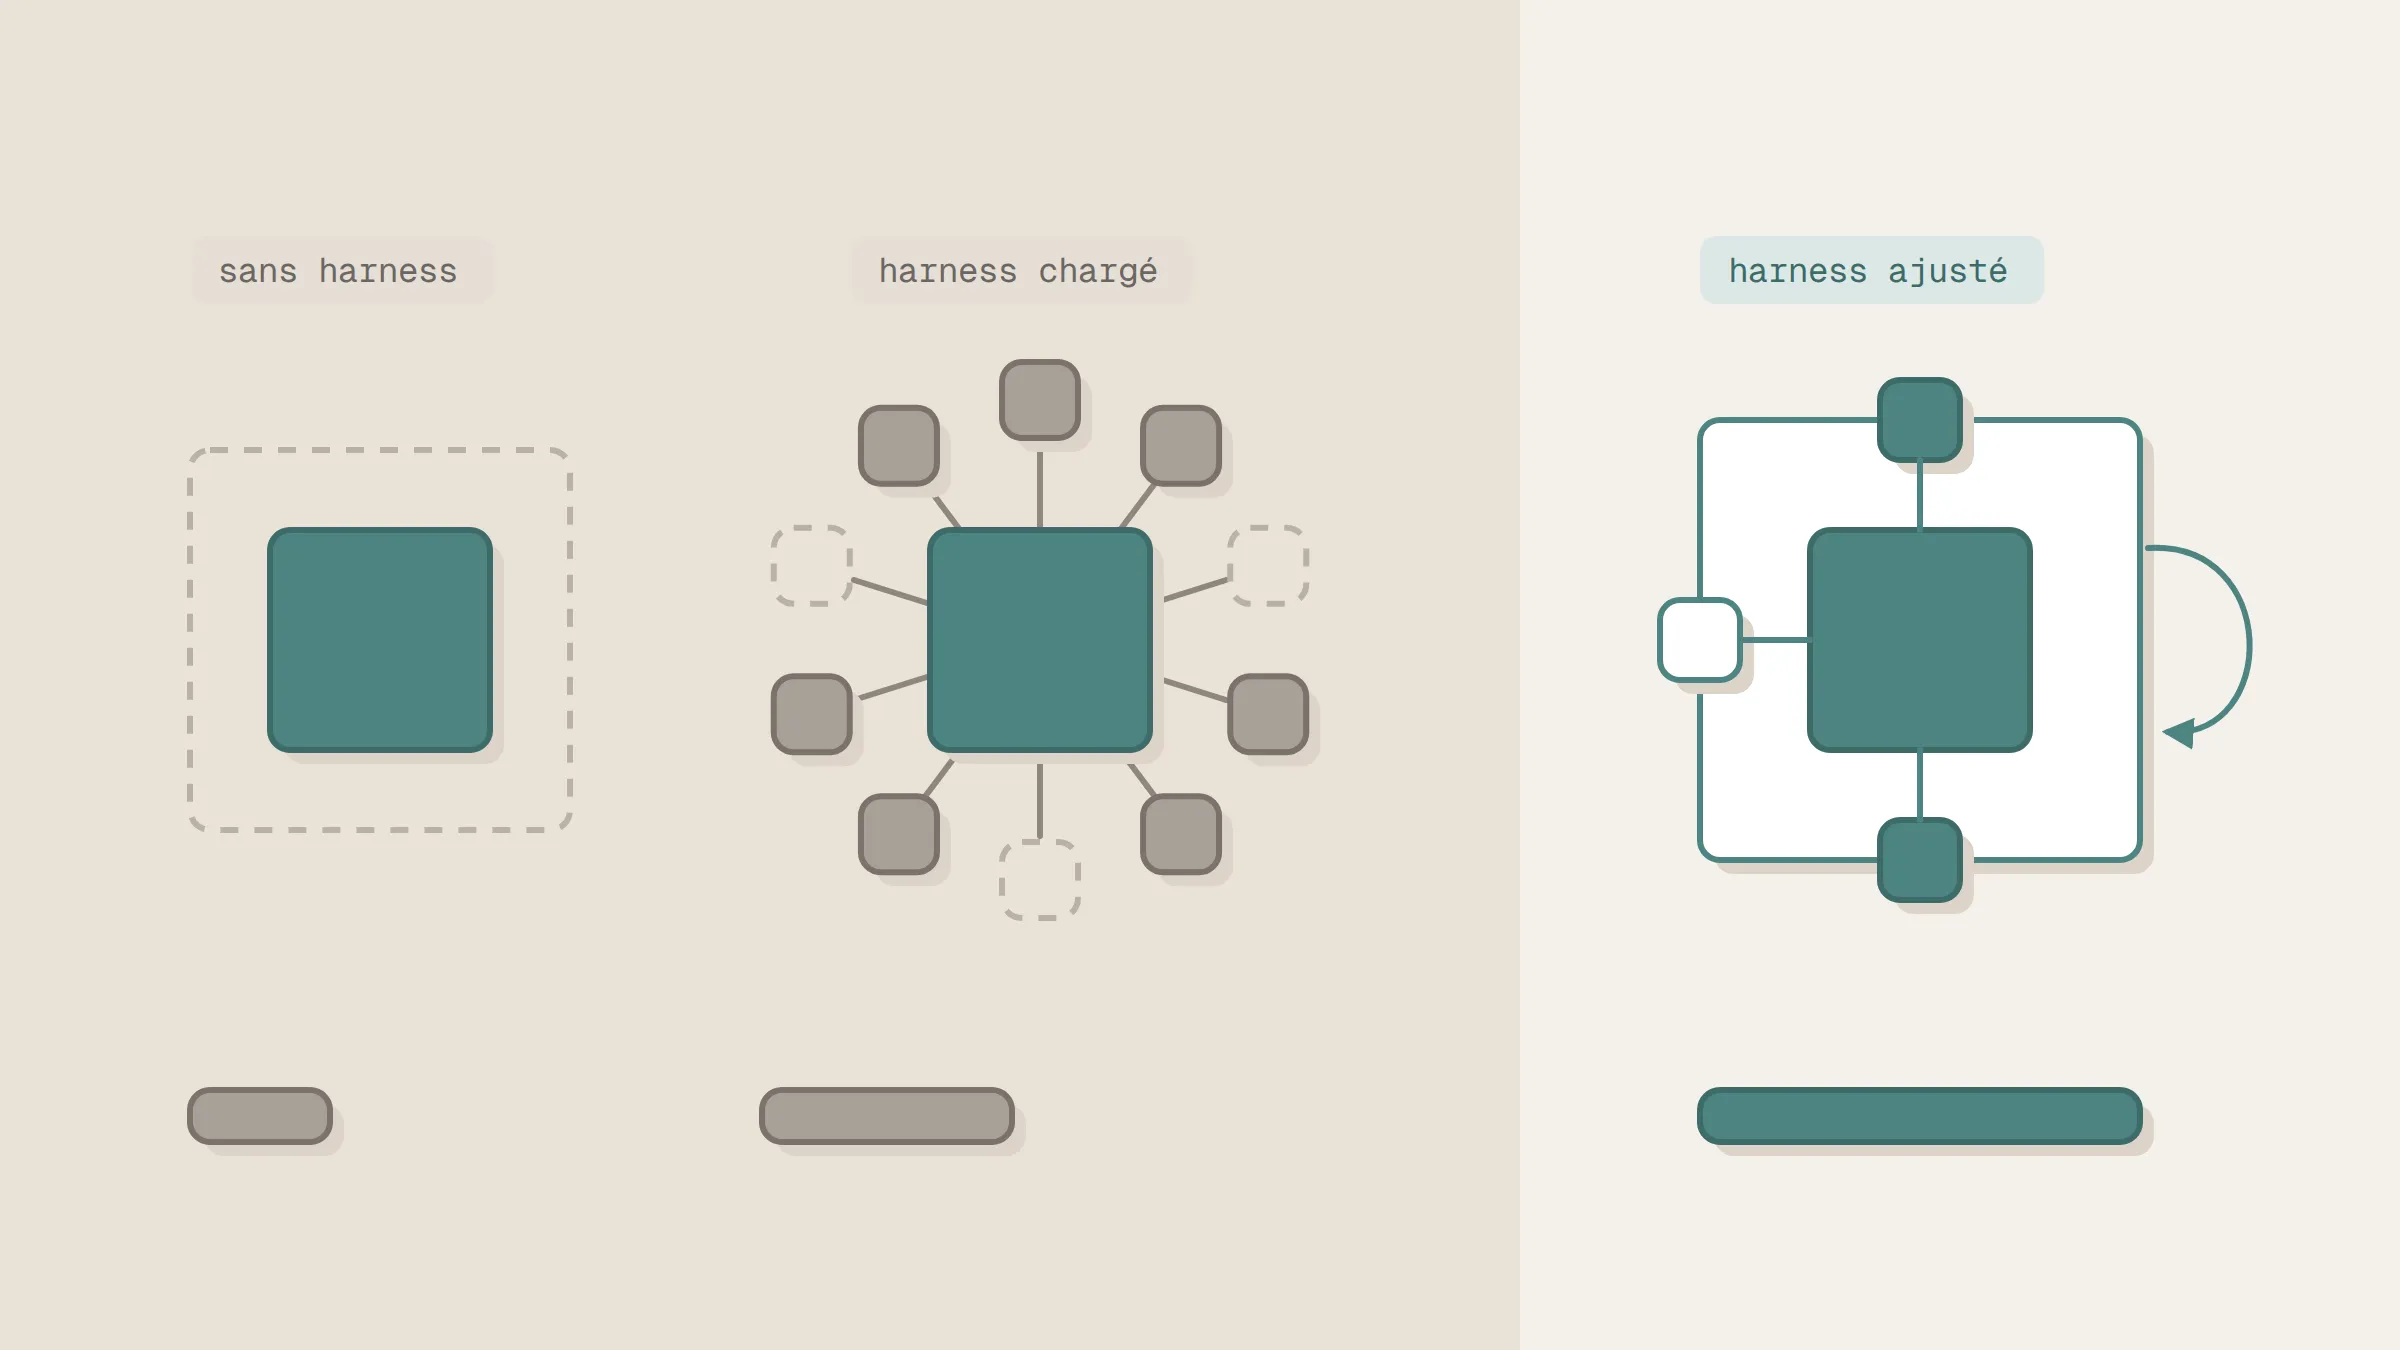
Un harness IA est le logiciel qui entoure un modèle de langage pour en faire un agent capable d’agir : il fait tourner la boucle de travail, fournit les outils, choisit ce que le modèle lit et fixe ce qu’il a le droit de faire. Quand on me demande s’il vaut mieux Claude ou ChatGPT, la question ne porte que sur le modèle et oublie le harness et le contexte. Le contexte désigne ce que l’entreprise donne à lire à l’agent : ses consignes, ses règles métier, sa documentation. À modèle identique, le harness et le contexte peuvent plus que doubler le taux de réussite d’un agent. Je choisis donc le modèle et le harness ensemble, selon la tâche, et je construis le contexte avant tout le reste.
Qu’est-ce qu’un harness IA ?
Le harness désigne toute la partie logicielle d’un agent IA qui n’est pas le modèle. La documentation de Claude Code (consultée en novembre 2026) le formule ainsi : la boucle d’un agent repose sur des modèles qui raisonnent et des outils qui agissent, et Claude Code est « la couche autour du modèle qui fournit les outils et gère le contexte que le modèle voit ». C’est cette couche que l’on appelle harness.
Le mot anglais veut dire harnais, la pièce qui transmet la force du cheval à la charrette. De la même façon, un modèle seul produit du texte. Branché dans un harness, il lit des fichiers, lance des commandes, vérifie son travail et recommence jusqu’à ce que la tâche soit finie. Le mot harness reste rare en français, et sa traduction « harnais » l’est plus encore : je garde le terme anglais.
Les six fonctions d’un harness
| Fonction | Ce qu’elle fait | Exemple dans Claude Code |
|---|---|---|
| Boucle d’exécution | Rappelle le modèle après chaque action, jusqu’à la fin de la tâche | Recueillir le contexte, agir, vérifier, recommencer |
| Outils | Donnent au modèle de quoi agir | Lecture et édition de fichiers, terminal, recherche web, connexion à d’autres logiciels par MCP |
| Gestion du contexte | Choisit ce que le modèle lit et résume ce qui déborde | Fichier de consignes lu au démarrage (CLAUDE.md), modes d’emploi chargés seulement quand la tâche en a besoin (skills), résumé de la conversation quand elle devient trop longue |
| Permissions | Fixent ce que l’agent fait seul et ce qu’il demande | Trois modes : l’agent demande avant d’agir, agit seul, ou propose un plan sans rien modifier |
| Sous-agents | Délèguent une tâche dans un contexte séparé | Exploration du code, relecture, tâches parallèles |
| Mémoire | Garde des acquis d’une session à l’autre | Fichier de consignes (CLAUDE.md) et notes que l’agent garde d’une session à l’autre |
Le contexte, lui, ne fait pas partie du harness. C’est ce que l’entreprise lui donne à lire : ses consignes, ses règles métier, sa documentation, l’état de ses projets. Le harness décide seulement quand et comment ce contexte arrive devant le modèle.
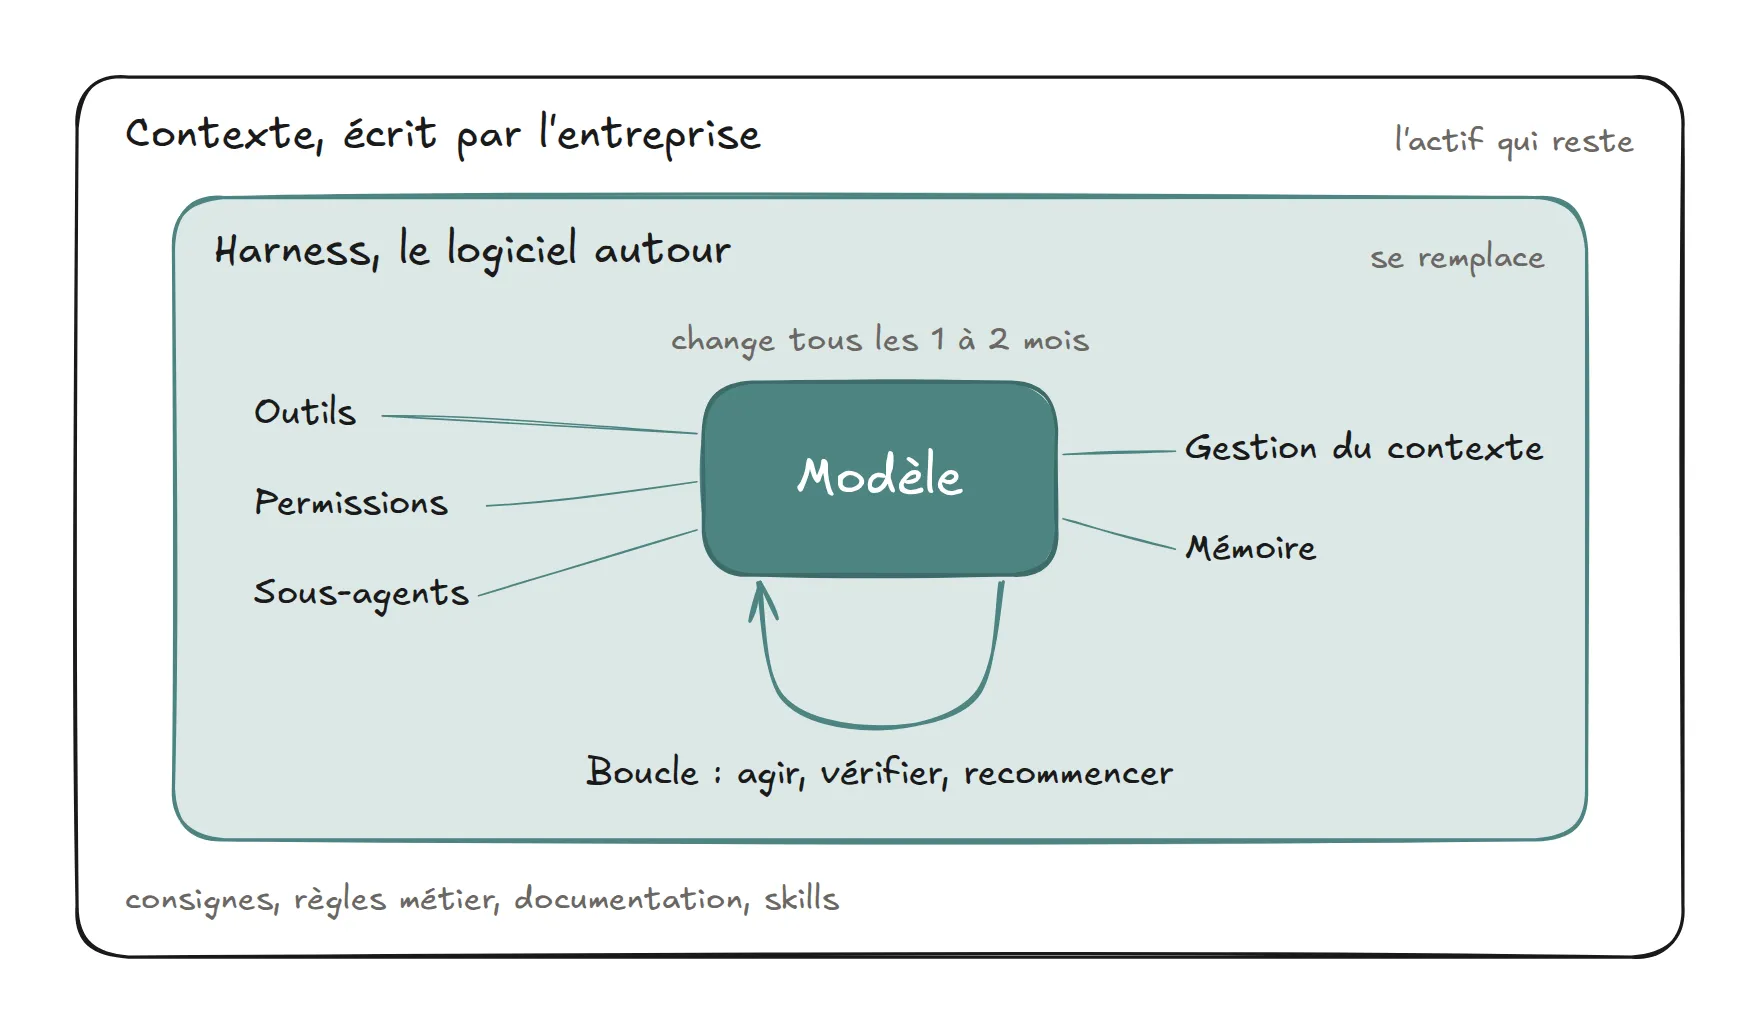 Légende : le meilleur modèle du marché change tous les un à deux mois. Le contexte, écrit dans des fichiers, se garde quand on change de modèle ou de harness.
Quels sont les principaux harness d’agents IA en 2026 ?
Les harness les plus utilisés pour le code en novembre 2026 se distinguent surtout par leur rapport aux modèles : certains sont conçus pour une famille de modèles, d’autres acceptent n’importe quel fournisseur. Le niveau d’équipement varie aussi beaucoup, du harness qui embarque tout à celui qui se contente de quatre outils.
| Harness | Éditeur | Modèles | Parti pris |
|---|---|---|---|
| Claude Code | Anthropic | Claude, ou un autre modèle derrière une API compatible | Complet : skills, hooks (scripts lancés automatiquement à certaines étapes), MCP, sous-agents, mode plan |
| Codex | OpenAI | GPT en priorité | Conçu autour des modèles d’OpenAI, consignes dans AGENTS.md |
| OpenCode | Projet open source | Multi-fournisseurs | Relit les skills et le CLAUDE.md de Claude Code |
| Cursor | Anysphere | Multi-fournisseurs | Éditeur de code dont le harness est ajusté à chaque modèle |
| Pi | Earendil | Multi-fournisseurs | Minimal : lire, écrire, éditer, lancer une commande ; ni sous-agents ni mode plan |
J’en utilise trois au quotidien depuis septembre 2026 : Claude Code, Codex et Pi. Ils tournent sur un serveur dédié et je les pilote depuis une même interface, Paseo, qui enregistre chaque paire modèle et harness sous forme de profil. Le pourquoi de cette installation fait l’objet d’un article sur les agents IA qui tournent sur un serveur isolé.
Le même modèle donne-t-il le même résultat dans deux harness ?
À modèle identique, le harness change le taux de réussite d’un agent, parfois du simple au double. Le classement HAL de l’université de Princeton le mesure sur CORE-Bench Hard, un banc qui demande de reproduire les résultats d’articles scientifiques publiés à partir de leur seul code. Claude Opus 4.5 y réussit 33 % des tâches dans le harness généraliste du classement, 42 % dans CORE-Agent et 78 % dans Claude Code (classement consulté en novembre 2026). Après correction manuelle de quelques erreurs de notation, le score de Claude Code monte à 95,5 %, au point que l’équipe a déclaré le banc résolu.
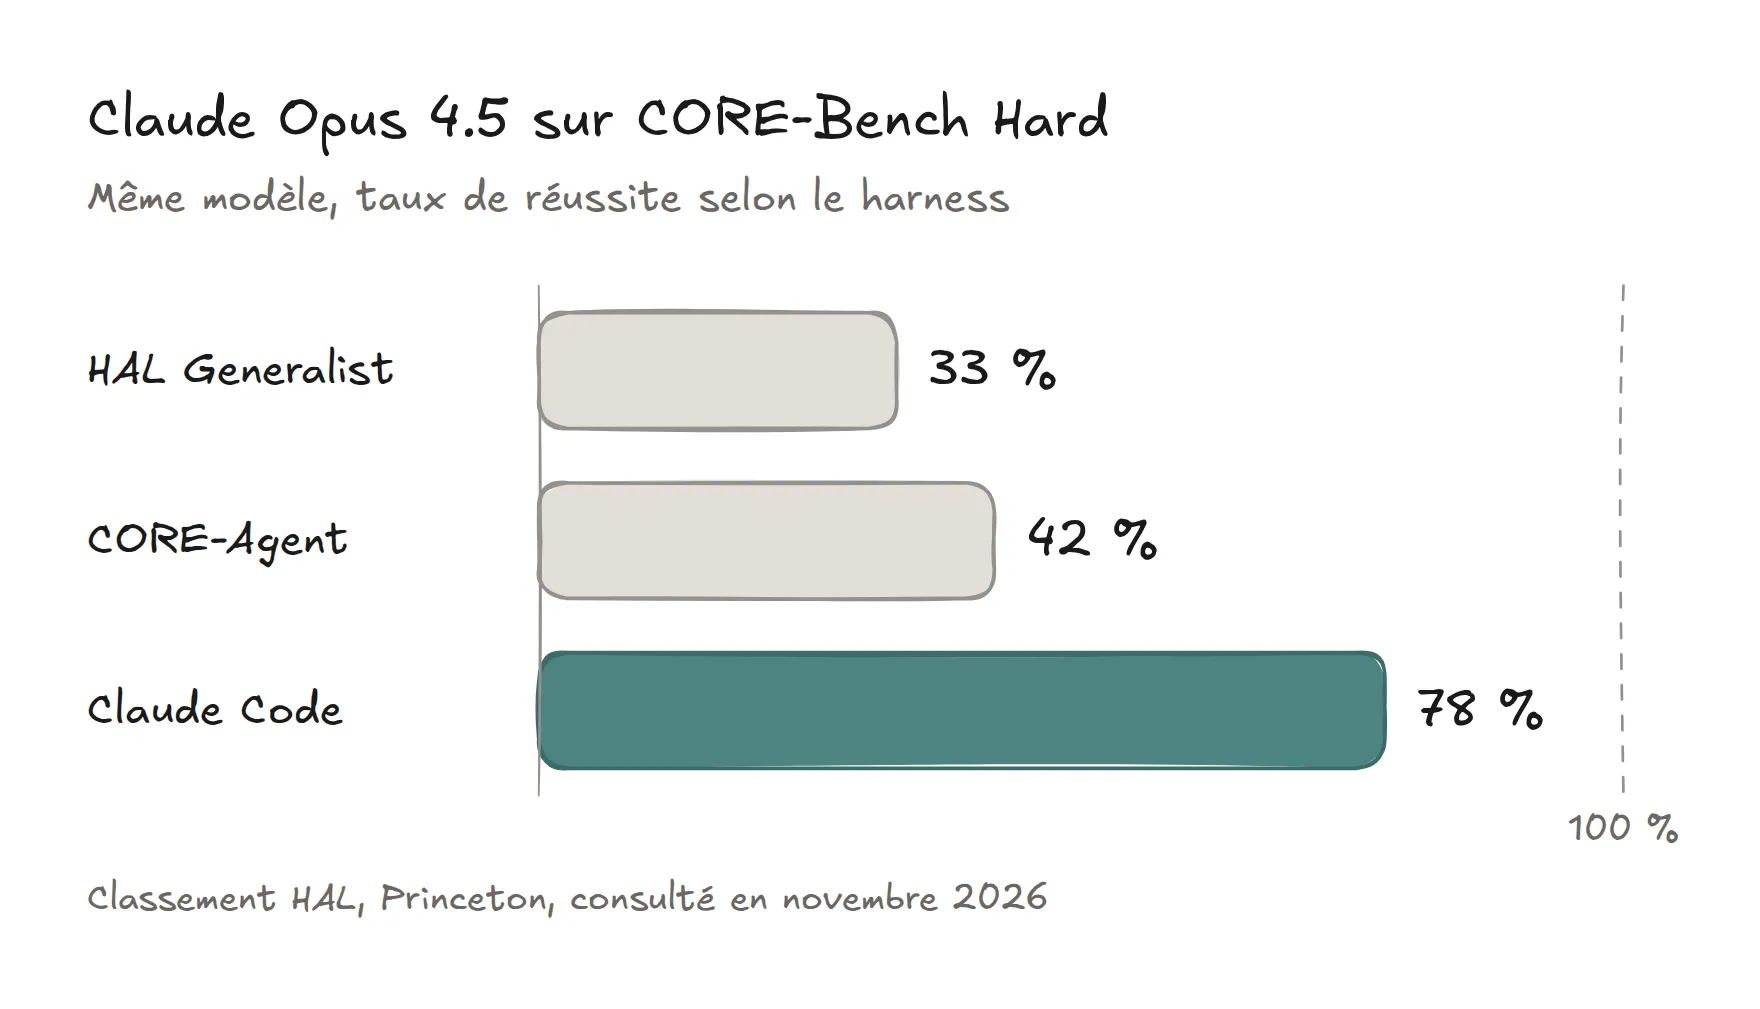 Légende : un seul modèle, trois harness, un taux de réussite qui fait plus que doubler.
Composio a fait l’exercice avec un autre modèle en septembre 2026 : DeepSeek V4 Flash, trente tâches difficiles, huit harness. Les scores vont de 14 tâches réussies avec OpenCode à 20 avec Pi, en passant par 16 pour Claude Code et Codex. Les tâches, les outils externes et le vérificateur étaient les mêmes partout. L’écart vient du harness.
Les éditeurs le savent. En décembre 2025, Cursor expliquait que chaque modèle demande des consignes et des réglages propres dans son harness, parce que chaque laboratoire entraîne ses modèles avec ses propres outils et instructions. Sur leur banc d’essai interne, quand le harness cessait de transmettre à GPT-5-Codex les notes de raisonnement qu’il avait rédigées aux étapes précédentes, ses performances chutaient de 30 %.
J’ai fait l’essai inverse : placer un modèle dans un harness réglé pour un autre. En avril 2026, j’ai branché Kimi K2.6, un modèle chinois alors présenté comme une alternative crédible à Claude Opus, dans Claude Code. Le branchement a été simple et a marché du premier coup, et DeepSeek documente aujourd’hui la même configuration pour ses modèles. Un branchement qui fonctionne ne garantit pas pour autant la qualité du travail : Claude Code est réglé pour les modèles Claude, et Kimi y travaille avec des outils et des consignes qui ne sont pas les siens.
Pourquoi le contexte pèse-t-il autant que le modèle ?
Un modèle ne sait de votre entreprise que ce qu’on lui donne à lire : quand ce contexte est complet, deux modèles de même gamme livrent des résultats proches. Je l’ai vérifié chez un client qui faisait modifier ses automatisations, construites dans l’outil n8n. Deux modèles de même niveau disposaient des mêmes documents et des mêmes accès à ses outils, et tous deux ont livré une modification qui fonctionnait.
Le contexte dont je parle tient en peu de choses. Il réunit l’identité de l’entreprise et ses projets, ses domaines métier avec leurs contraintes, et les règles qui disent à l’IA comment s’en servir. Il vit dans des fichiers texte (un CLAUDE.md ou un AGENTS.md, des skills, une base de notes) que la plupart des harness savent lire.
En juillet 2026, j’ai installé OpenCode, un autre harness, à côté de Claude Code. En une quinzaine de minutes, il avait repris mes fichiers de consignes et mes skills, des modes d’emploi écrits pour des tâches précises, parce qu’il les cherche aux mêmes emplacements que Claude Code. Les extensions et les connexions à d’autres logiciels ont dû être réinstallées, et la mémoire des sessions passées n’a pas été reprise.
Ce contexte passe donc d’un harness à l’autre. C’est pourquoi, dans les assistants et agents IA que je mets en place en entreprise, le contexte est construit avant le choix du modèle. La tête du classement change tous les un à deux mois : rien qu’en septembre 2026, Anthropic a publié Claude Fable 5.1 puis Opus 5.5. Une base de contexte bien rangée survit à ces changements, et à un changement de fournisseur.
Un harness plus complet fait-il un meilleur agent ?
Un harness plus équipé ne fait pas forcément un meilleur agent. Chaque outil et chaque consigne qu’il embarque s’ajoute au texte que le modèle lit à chaque étape, et ce texte se paie en tokens, les fragments de mots que les fournisseurs facturent. En septembre 2026, j’ai relevé ce que trois harness font lire au modèle avant même le premier message : environ 52 000 tokens dans Claude Code, 29 000 dans Codex, 3 000 à 4 000 dans Pi. Ce sont des ordres de grandeur. Claude Code fait donc lire au modèle plus de dix fois plus de texte que Pi. Cet équipement sert sur une tâche ouverte. Sur une tâche bien cadrée, il coûte des tokens sans améliorer le résultat.
Le banc de Composio va dans le même sens. Pi, qui ne donne au modèle que quatre outils et des consignes de base de quelques centaines de tokens, a battu OMP, un dérivé qui en ajoute une trentaine : 20 tâches réussies contre 17, avec un quart de tokens en moins par tâche. Les auteurs concluent qu’à partir d’un certain point, plus de harness coûte des tokens et du temps sans améliorer le résultat.
Le harness pèse aussi sur la facture par ses réglages par défaut. Dans Claude Code, un sous-agent, c’est-à-dire un agent secondaire auquel l’agent principal confie une partie du travail, utilise par défaut le même modèle que l’agent principal. Un jour de septembre 2026, ma procédure de relecture de code a ainsi lancé vingt et un sous-agents, tous sur le modèle le plus puissant d’Anthropic, ce qu’on appelle un modèle frontière, réglé pour réfléchir longuement avant de répondre. Au tarif public à l’usage, cette journée aurait coûté 147 dollars. Je travaillais sous abonnement forfaitaire, et cette somme ne m’a pas été facturée. Depuis, chaque sous-agent part avec un modèle choisi. Le détail de ces arbitrages se trouve dans l’article sur le coût réel de l’IA générative en entreprise.
Comment choisir le modèle et le harness selon la tâche ?
Pour une tâche floue ou qui fixe la suite du projet, comme cadrer un besoin ou répartir le travail entre plusieurs agents, j’associe un modèle frontière à un harness complet. Pour exécuter un plan déjà écrit, j’associe un modèle moins cher à un harness léger.
| Tâche | Ce qui compte | Harness | Modèle (septembre 2026) |
|---|---|---|---|
| Cadrer un projet, orchestrer des agents | Comprendre un besoin flou, découper, arbitrer | Claude Code | Claude Fable 5.1 |
| Livrer une fonctionnalité cadrée | Tenir un plan sur plusieurs fichiers | Codex | GPT-5.6 Sol |
| Exécuter une tâche d’un plan validé | Suivre un brief sans se disperser | Pi | GPT-5.6 Terra |
| Relire le code avant fusion | Trouver les défauts, ignorer le reste | Pi | GPT-5.6 Sol |
| Tâche déterministe et répétée | Fiabilité, coût quasi nul par exécution | Workflow n8n | Aucun |
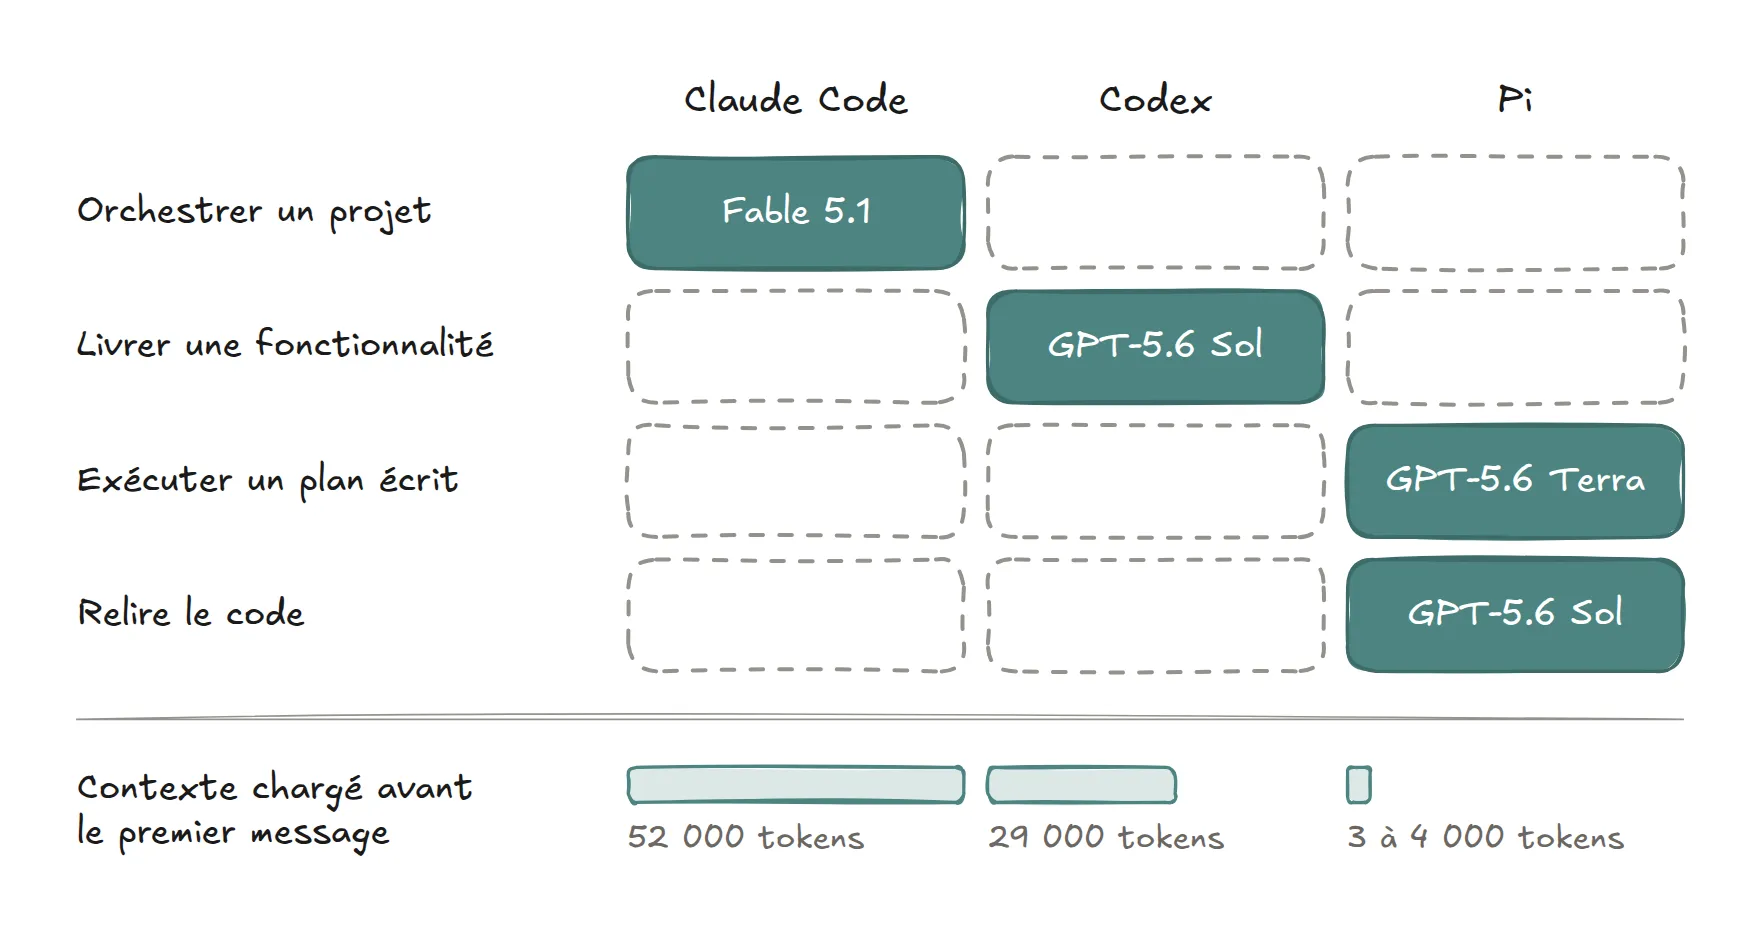 Légende : chaque tâche a son harness, et Pi charge plus de dix fois moins de texte que Claude Code avant le premier message.
Ces choix viennent de tests sur de vrais cas. Pour choisir le modèle de relecture, j’ai donné les mêmes consignes à plusieurs modèles, sur une modification de code qui contenait deux défauts connus. GPT-5.6 Sol, dans Pi, a trouvé les deux défauts et trois autres incohérences réelles, en quatre minutes, pour environ 0,80 dollar au tarif public. GPT-5.5, pourtant réglé pour réfléchir plus longtemps, n’a relevé que deux de ces cinq problèmes. Une relecture par Claude coûtait de son côté entre 5 et 30 dollars au tarif public.
La dernière ligne du tableau compte autant que les autres. Une tâche parfaitement déterministe (déplacer des comptes rendus de réunion vers un CRM, par exemple) n’a besoin d’aucun modèle : je l’ai reconstruite dans n8n, à l’ancienne, et elle ne consomme plus un token.
La démarche vaut hors du code. Pour l’assistant IA du support d’Izuba énergies, le modèle a été choisi sur son coût et sa qualité, mesurés sur des questions réelles du support avant la mise en production.
Par où commencer
Le point de départ est le contexte, et le choix de la paire modèle et harness vient après. Dans l’ordre :
- Écrire le contexte dans des fichiers que tout harness sait lire : consignes générales, règles métier, documentation, skills.
- Classer ses tâches en trois familles : floues ou structurantes, cadrées et répétées, déterministes.
- Réserver le modèle frontière et le harness complet à la première famille.
- Tester un modèle moins cher dans un harness léger sur la deuxième famille.
- Sortir la troisième famille de l’IA : un workflow classique la traite pour un coût par exécution quasi nul.
- Fixer le modèle de chaque sous-agent, au lieu de le laisser hériter de celui de la conversation.
- Comparer deux paires sur un cas réel dont on connaît la bonne réponse, avant de généraliser.
L’audit en amont d’un projet d’assistant IA sert à poser deux éléments : la base de contexte de l’entreprise, et la répartition de ses tâches entre les paires modèle et harness.